

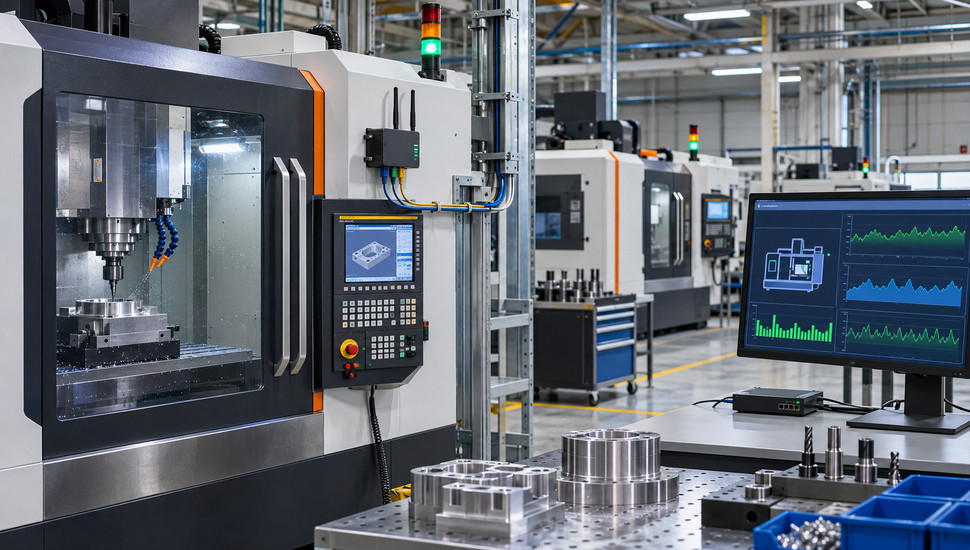
IoT-мониторинг станков: что даёт и с чего начать
IoT-мониторинг станков — это автоматический сбор данных о работе оборудования: наработка, простои и их причины, аварии, потребление энергии. Он заменяет бумажные журналы и отчёты мастеров объективной картиной парка, показывает, где цех теряет часы, и переводит техобслуживание с календарных дат на фактическую наработку. Начинать нужно не с покупки платформы на весь завод, а с пилота на 2–3 станках с заранее записанными вопросами и критериями успеха.
Цех выглядит занятым: станки гудят, стружка летит, план на бумаге идёт. Потом месяц закрывается, и выясняется, что выпуск ниже плана, а объяснить это никто толком не может. Причина в том, что данные о парке в большинстве цехов собираются вручную: мастер обходит станки, оператор пишет в журнал, нормировщик переносит цифры в Excel. Каждый в этой цепочке показывает то, что удобно показать, — а руководитель принимает решения на основе этих показаний.
«Мутная вода» на производстве удобна многим: и операторам, и начальникам цехов, и тем, кто формирует заявки на инструмент и новые станки. Система мониторинга эту воду осушает: она снимает данные прямо со стоек ЧПУ и датчиков, без участия человека, и хранит их в виде, который нельзя переписать задним числом.
Ниже — разбор для руководителя: какие данные реально снимаются со станка, какие решения они открывают, какие эффекты дают внедрения в цифрах, где эти цифры врут, как провести пилот на 2–3 станках и на какие подводные камни закладываться заранее.
Ключевое
- Мониторинг закрывает четыре класса данных: наработка, простои с причинами, аварии и состояния узлов, потребление энергии. По каждому классу руководитель принимает конкретное решение — от графика ТО до обоснования покупки нового станка.
- Типовой эффект по данным внедрений: сокращение простоев на 30–40%, рост загрузки оборудования на 15–25%, окупаемость проекта за 2–6 месяцев. Повышение коэффициента использования оборудования на 15% на участке из 10 станков даёт экономию 10–20 млн рублей в год.
- Ловушка «работает/не работает»: если система видит только факт включения, её легко обмануть (вплоть до затянутых пауз в программе), а сокращение простоя само по себе не добавляет выпуск. Мерить нужно полезную работу — время резания под нагрузкой.
- Пилот на 2–3 станках за 4–8 недель отвечает на вопрос «что это даст именно нам» дешевле и честнее любого демо: базовый замер «до», 3–5 метрик, еженедельный разбор.
- Главные риски проекта — не техника, а организация: купленная без вопросов система, которую никто не читает; сопротивление персонала («слежка»); ручной ввод причин простоев вместо автоматики.
Что такое мониторинг станков: данные вместо бумажного журнала
Система мониторинга станков (их называют ещё системами сбора машинных данных) автоматически опрашивает оборудование и фиксирует его состояние: работает станок или стоит, какую программу выполняет, с какой нагрузкой, когда и почему остановился. Опрос идёт раз в несколько секунд, поэтому картина получается непрерывной: не «сменный итог со слов мастера», а секундная хронология работы каждого станка. Термин «IoT» здесь означает промышленный интернет вещей: датчики и стойки сами отдают данные, без людей с планшетами. Стойка ЧПУ при этом не изменяется — данные читаются через штатные сетевые интерфейсы, а там, где сети нет, ставятся датчики тока.
От привычного учёта система отличается одним свойством: данные не проходят через человека, который может их отфильтровать. В журнале оператор записывает «простой 20 минут, смена инструмента» — и никто не проверит, что на деле станок стоял полтора часа. Система фиксирует остановку в момент, когда она случилась, и хранит её без правок. Именно поэтому показатели загрузки, собранные автоматически, на практике обычно оказываются заметно ниже «журнальных»: бумага систематически приукрашивает.
Как это выглядит на живом примере. На одном российском производстве учёт загрузки вёл специалист пешим обходом: листик А4, потом Excel, показатели полного и рабочего времени списывались с блоков ЧПУ Fanuc. Сначала заметили аномалию: наработка за период «пошла в обратную сторону» — рабочее время второго месяца оказалось меньше первого, хотя такого не бывает физически. Ввели второго учётчика для дублирования — получили, по словам ведущего инженера по оборудованию, «абсолютный хаос в снимаемых метриках, очень хмурого директора и отсутствие понимания времени переналадки и простоев».
Этот набор проблем и стал отправной точкой внедрения мониторинга.
| Вопрос | Бумажный журнал и Excel | Автоматический мониторинг |
|---|---|---|
| Кто вносит данные | Оператор и мастер, вручную | Система, без участия человека |
| Как быстро видно простой | На следующем обходе или в конце смены | В момент остановки, с уведомлением |
| Можно ли проверить запись | Нет — только опросом свидетелей | Да — хронология хранится целиком |
| Причины простоя | Со слов, задним числом | Автоматически по статусу стойки, при необходимости уточняются вручную |
| Затраты на сбор | Часы работы людей каждый день | Разовая настройка и поддержка |
Бумажные журналы наработки и простоев — не враг, а этап: пока их ведут честно, они дают базу для сравнения. Проблема начинается, когда журнал становится отчётностью, за которую отвечают. Состав цеховых журналов и порядок ведения сервисной документации разобраны в услуге ведения сервисной документации; мониторинг поверх такой формы превращает её из «обязанности» в источник решений.
Какие данные снимаются со станка и какие решения они дают
Перечень «система собирает данные» бесполезен для руководителя без второй колонки — что он делает с каждым типом данных. Разобьём весь поток на четыре класса.
| Класс данных | Что видно | Решение руководителя |
|---|---|---|
| Наработка | Часы работы под нагрузкой, циклы, счёт деталей | ТО по факту наработки, план ЗИП, обоснование дозагрузки или покупки станка |
| Простои и причины | Когда стоял, сколько, почему (нет заготовки, наладка, ожидание мастера) | Изменение организации смены, подготовки инструмента и логистики заготовок |
| Аварии и состояния | Коды аварий, остановы, температура и вибрация узлов (с датчиками) | Приоритет ремонтов, заказ запчастей до отказа, ремонт вместо внеплановой аварии |
| Энергия | Потребление по станку и сменам, работа вхолостую | Расписание включения, отключение простаивающего оборудования, расчёт себестоимости |
Наработка — базовая валюта мониторинга. Стойки ЧПУ ведут собственные счётчики: время работы, время под нагрузкой, количество выполненных программ. У Fanuc эти данные доступны в диагностике, и снять их можно даже без системы мониторинга — пошаговая инструкция, как посмотреть наработку в часах на ЧПУ Fanuc, описывает ручной способ. Ручной способ даёт цифру раз в месяц при обходе; мониторинг собирает её непрерывно по всему парку и раскладывает по станкам, сменам и операциям. Из этой цифры вырастает всё остальное: график ТО по фактическим часам, а не «раз в квартал»; сравнение двух одинаковых станков, из которых один делает 900 деталей за смену, а второй — 650.
Простои и причины — главный источник «найденных денег». Автоматика различает состояния: работа по программе, наладка, ожидание, авария, выключен. Первый месяц вскрытия обычно показывает набор «невидимых» потерь: пересменки, на которых цех теряет по 20–40 минут, блокировки подач в ночные смены, затянутые технологические остановы, станки, ожидающие заготовку. Каждая найденная потеря — это управленческое решение: перестроить пересменку, готовить инструмент вне станка, перераспределить транспорт.
Аварии и состояния узлов — мостик к ремонту. Журнал аварий стойки, собираемый автоматически, показывает, какие узлы и как часто останавливают станок; как читать такой журнал — отдельный материал. Поверх базовых статусов ставятся датчики: температура на корпусах подшипников шпинделя, вибрация, давление в пневмосистеме, уровень масла. Тренд температуры подшипника за две недели — это заказ подшипника в плановый выходной, а не внеплановая остановка на три дня посреди сменного задания. Именно на этих данных строится предиктивная диагностика станков — она ловит износ за недели до отказа.
Энергия — самый недооценённый класс. Токовые датчики на вводе питания дают потребление по каждому станку. Практический эффект двоякий: во-первых, видны станки, которые «греют цех» в простое — их отключение по расписанию экономит до 5–10% электроэнергии парка; во-вторых, появляется честная себестоимость детали по станкам и операциям. Фирменные средства это уже поддерживают штатно: в Heidenhain StateMonitor контроль потребления энергии и связь с системами планирования добавлены производителем стойки как стандартные функции.
Отдельный случай — старый парк: универсальные станки с 2Р22, NC-201 или вообще без ЧПУ. С них нечего читать по сети, но факт «работает/стоит» и потребление снимаются токовым датчиком с силового кабеля. Мониторинг парка собирает и такие станки — часто именно они оказываются самыми недозагруженными или, наоборот, самым узким местом.
Что это даёт в цифрах: эффекты и где они врут
Соберём эффекты, которые называют внедрения и обзоры, в одну таблицу.
| Показатель | Типовой эффект | За счёт чего |
|---|---|---|
| Незапланированные простои | −30–40% | Уведомления в момент остановки, работа с причинами, прозрачность смен |
| Загрузка оборудования | +15–25% | Возврат в производство «невидимых» потерь: пересменки, ожидания, наладки |
| Затраты на ТО | до −25% | ТО по наработке вместо календаря, ЗИП по данным аварий |
| Брак | −10–15% | Контроль соблюдения режимов, привязка брака к станку, смене и программе |
| Электроэнергия | до −5–10% | Отключение простаивающего оборудования, расписание смен |
| Окупаемость проекта | 2–6 месяцев | Сумма перечисленного по ценам конкретного цеха |
Экономику одной строчки стоит расписать: повышение коэффициента использования оборудования на 15% на участке из 10 станков даёт экономию 10–20 млн рублей в год — это расчёт для реального участка металлообработки, без покупки новых станков. Иначе говоря, дозагрузка существующих станков даёт ту же прибавку мощности, что покупка нового станка за 20–40 млн рублей, — только без самой покупки.
OEE: один показатель вместо трёх споров. Мировой стандарт расчёта эффективности производственных операций — ГОСТ Р ИСО 22400-1-2016, где общая эффективность оборудования (OEE) определяется как произведение доступности (доля времени, когда станок мог работать), производительности (фактическая скорость против нормативной) и качества (годная продукция против всего выпуска). Система мониторинга считает его автоматически по каждому станку. Практическая ценность в том, что OEE раскладывает спор «у нас всё нормально» на три слагаемых, и сразу видно, какое из них тянет вниз: цех с доступностью 90% и производительностью 55% не нуждается в новых станках — ему нужно разбираться с режимами резания и нормами времени.
Теперь о том, где цифры врут.
Первое вранье — сокращение простоев как самоцель. Разберём на расчёте из практики внедрений: пусть час работы станка стоит 1000 рублей и станок простаивал за год 4380 часов. Сокращение простоя на 1% выглядит как выгода 43 800 рублей в год — но только если высвобожденное время занято полезной работой. Если выпуск не вырос, выгоды нет: станок «меньше стоял» при тех же деталях.
На одном станке за год полезная работа составила 2190 часов и 1500 деталей; снижение полезной работы на 1% высвобождает 21,9 часа машинного времени — при тех же 1500 деталях.
Поэтому правильная цель мониторинга — не «минус простой», а «плюс детали на час полезного времени».
Второе вранье — красивая загрузка. Если после внедрения мониторинга на графиках стабильно стоит загрузка 70% и выше — это признак того, что систему обманывают или она считает «включён», а не «режет металл». Стойка не различает обработку и работу вхолостую, если система смотрит только на факт включения. Известен и обратный приём со стороны персонала: затянутая пауза в управляющей программе (станочные макросы позволяют «висеть» в кадре задержки сколько угодно), чтобы станок числился занятым.
Вывод для покупателя: спрашивайте у системы, как она отличает резание от холостого хода. Ответ «по статусу стойки» означает, что отличать она не умеет.
Третье враньё — средний OEE по цеху. Средняя температура по больнице прячет и станок-чемпион с OEE 70%, и станок-аутсайдера с 25%. Управленчески полезен только разрез по станкам, сменам и типам операций; его и требуйте в отчётах.
ТО по состоянию вместо календаря: эффект для механики
Календарное техобслуживание устроено расточительно по определению: станок с наработкой 3000 часов в год и станок с 800 часами обслуживаются «раз в квартал» одинаково. Первый при этом обслуживается слишком редко относительно износа, второй — слишком часто относительно смысла. Термины здесь уместны из ГОСТ 27.002-2015 «Надёжность в технике»: наработка, наработка на отказ, коэффициент готовности. Мониторинг делает все три измеримыми по каждому станку, а коэффициент готовности — управляемым показателем с ответственным.
Что меняется в практике механика:
- Регламент привязывается к часам. Смазка направляющих «каждые 500 часов работы под нагрузкой» вместо «раз в месяц» — у станка с трёхсменной работой месяц равен четырём, у простаивающего — трём дням. Сервисное сопровождение оборудования по договору переходит на объёмы по наработке: дешевле для недогруженного парка, честнее для загруженного.
- ЗИП покупается по данным, а не «на всякий случай». Журнал аварий и счётчики циклов показывают, какие узлы останавливают парк чаще всего и на какой наработке это происходит. Вместо склада «всего понемногу» — склад того, что реально уходит: фильтры, датчики, реле, ремни в объёме фактического расхода.
- Узлы входят в отказ постепенно — и это видно. Растущая температура подшипников шпинделя, вибрация на определённых оборотах, падение давления в пневмосистеме ночью — тренды дают от двух до восьми недель форы до отказа. Это и есть предиктивная диагностика: не магия, а датчики плюс график.
- Приоритет ремонтов перестаёт быть предметом спора. Время, потерянное на аварии каждого станка, считается автоматически. Ремонтируется первым не тот, кто громче жалуется, а тот, кто съедает больше сменных часов — и цифры это показывают.
Для парка из 10–30 станков эти четыре пункта дают заметную часть всего эффекта мониторинга — иногда большую, чем борьба с простоями: внеплановая остановка обрабатывающего центра на трое суток стоит дороже, чем месяц мелких потерь по пять минут.
С чего начать: пилот на 2–3 станках
Пилот — способ ответить на вопрос «что это даст нам» за 4–8 недель и за цену двух-трёх подключений вместо завода. Ниже маршрут, который проходит за один заход.
Шаг первый. Сформулируйте вопросы, на которые нужны ответы. Не «хочу видеть загрузку», а конкретика: почему второй сменой делается вдвое меньше; сколько времени станок №7 ждёт заготовку; какие узлы чаще всего останавливают парк; сколько реально нарабатывает каждый станок между обслуживаниями. Пять вопросов — этого достаточно. Система без вопросов продаёт отчёты, которые никто не читает.
Шаг второй. Выберите 2–3 станка пилота. Критерии в таблице.
| Критерий выбора | Почему так |
|---|---|
| Узкое место плана или самый спорный станок | Эффект на нём виден сразу и в деньгах |
| Разные типы: токарный + фрезерный (или ОЦ) | Проверяются разные сценарии работы и статусы |
| Разные стойки (например, Fanuc и Siemens) | Сразу видны различия каналов сбора — при масштабировании не будет сюрприза |
| Худшая по дисциплине смена | Если система выживет и поможет там, она поможет везде |
| Станок без ЧПУ — опционально | Токовый датчик проверит «слепой» путь сбора для старого парка |
Шаг третий. Снимите базу «до». Две недели фиксируйте вручную: начало и конец работы, остановки, причины со слов оператора, счёт деталей. Форма — простая таблица на листе у станка. Без этой базы пилоту нечем будет хвастаться: «стало лучше» требует «было вот столько».
Шаг четвёртый. Задайте критерии успеха числами. Рекомендуемый набор для пилота:
| Метрика | Как мерить | Целевое значение |
|---|---|---|
| Достоверность статусов | Выборочная сверка «что показала система» с фактом на станке, 2 раза в неделю | Совпадение в 95% проверок |
| Время реакции на остановку | Момент остановки по системе — момент начала разбора мастером | Сокращение с «часов» до 10–15 минут |
| Найденные «невидимые» потери | Разбор недельных отчётов | Минимум 3 конкретные потери с суммой в часах |
| Доля времени резания | Время под нагрузкой / общее время смены | Известна точная цифра по каждому станку (база для решений) |
| Решения | Протокол еженедельных разборов | Минимум 2 принятых изменения за пилот |
Шаг пятый. Работайте с данными еженедельно. 30 минут раз в неделю: мастер, наладчик, тот, кто отвечает за план. Смотрим топ потерь недели, назначаем одному владельцу одно изменение, на следующей неделе проверяем эффект. Пилот без регулярного разбора превращается в декорацию — данные копятся, решения не принимаются.
Шаг шестой. Посчитайте экономику. Возьмите найденные потери в часах, умножьте на стоимость часа простоя вашего станка (как считать час — отдельный материал с формулами) и сравните с ценой подключения парка. Эта страница расчёта — главный артефакт пилота: с ней идут к директору за бюджетом масштабирования, без неё — с обещаниями вендора.
Шаг седьмой. Масштабируйте партиями. После положительного решения подключайте парк партиями по 5–15 станков, начиная с участков, где пилот показал типовые потери. Ручной ввод причин простоя добавляйте со второго этапа: сначала автоматика должна показать «непредвиденные» потери (пересменки, блокировки, затянутые остановы) — они не требуют никого опрашивать и дают быстрый выигрыш.
Мини-пример из практики: участок с токарным станком советской постройки и обрабатывающим центром, обе машины — узкое место плана. Первая неделя пилота: у центра обнаружилось 55 минут ожидания наладчика в сутки, у токарного — 40 минут простоя «нет заготовки» во второй смене. Обе потери жили в цехе годами, потому что по отдельности каждая выглядела «пятиминуткой».
Сумма за год — около 290 станко-часов; при стоимости часа этого участка она закрыла стоимость мониторинга всего цеха. Технически обе машины подключаются за часы — как именно устроено подключение станка к системе мониторинга без остановки производства, мы разбираем в отдельном материале.
Подводные камни: почему проекты мониторинга не окупаются
Провальных внедрений больше, чем успешных, и почти всегда причина не в железе. Вот шесть типовых камней.
Камень первый. Система куплена без вопросов. Симптом: через месяц отчёты смотрит только интегратор на демонстрациях. Лекарство: шаг 1 пилота — вопросы и критерии успеха до подписания договора. Спросите себя, какое решение вы примете иначе, если увидите цифру, — если ответа нет, цифра не нужна.
Камень второй. «Это слежка за людьми». Сопротивление персонала — самый частый организационный тормоз. Внедрения показывают и жёсткие сценарии: фиксация работы «на сторону» и ночных пауз доходит до конфликтов и массовых увольнений. Снижать риск нужно до монтажа: показывать цеху потери, а не виноватых; первые месяцы работать с организацией (заготовки, инструмент, пересменки), а не с дисциплиной; честно сказать, что аварийные остановы в ночную смену теперь видны — это защита наладчика, которому больше не придётся доказывать, что авария была не по его вине.
Камень третий. Ручной ввод причин вместо автоматики. Дешёвые системы «старой школы» работают так: оператор сам отмечает, когда станок работает и почему остановился. Такая система увидит ровно то, что персонал захочет показать, — вопрос релокации «мутной воды» из бумаги в программу. Признак правильного порядка: состояния и остановы система определяет сама, человеку остаётся уточнение причин в спорных случаях — и не раньше второго месяца работы.
Камень четвёртый. Считает «включён», а не «режет». Уже разобранное враньё «работает/стоит»: затянутые паузы, холостые прогонки, «резание воздуха». Требуйте от системы различение работы под нагрузкой (по нагрузке осей или току шпинделя) — это стандартная функция у зрелых платформ, и её отсутствие означает, что вы покупаете счётчик включений.
Камень пятый. Сеть и безопасность не заложены в план. Самый рейтинговый ответ в обсуждении мониторинга на Reddit сводился к простому правилу: если построить сеть оборудования «как домашний компьютер», безопасно не будет; если выделить отдельный сегмент и закрыть канал — проблем нет. На практике это значит: отдельный сегмент сети для оборудования, закрытый доступ извне, списки портов для ИТ-службы. Сетевые сюрпризы начинаются раньше монтажа: у стоек бывает два Ethernet-порта, и маршрутизация между ними — отдельная задача; на смешанном парке у каждой системы ЧПУ свой канал обмена данными, и его готовность нужно проверять по серийным номерам стоек до подписания договора.
Камень шестой. Фирменный мониторинг только своих стоек. Лучшая иллюстрация из обсуждения пользователей: «Мы тестируем Heidenhain StateMonitor. Главная проблема — система почти не показывает, что происходит, когда станок не выполняет программу, и поддерживает только стойки Heidenhain». Родной мониторинг производителя хорош для однородного парка этой марки.
Для смешанного парка (Fanuc рядом с Siemens и Okuma) нужна независимая платформа, которая собирает данные с разных стоек в один отчёт, — иначе вы получите три системы, три интерфейса и три несравнимых отчёта.
| Ошибка | Симптом | Что делать |
|---|---|---|
| Нет вопросов и критериев | Отчёты никто не открывает | Пилот с шага «вопросы» и метриками успеха |
| Мониторинг как слежка | Саботаж, «сломанные» датчики, конфликт | Начинать с потерь и организации, не с дисциплины |
| Ручной ввод причин | Загрузка «внезапно» выросла после внедрения | Автоматические статусы, человек — только уточнение |
| Учёт «включён/выключен» | Загрузка 70%+ при прежнем выпуске | Различение нагрузки, метрика «время резания» |
| Сеть «как-нибудь потом» | Внедрение встало на ИТ-согласованиях | Сегмент сети и список портов — в план до монтажа |
| Фирменная система на смешанном парке | Три отчёта, несравнимые данные | Независимая платформа под весь парк |
И последнее: мониторинг не заменяет опытного мастера — это формулировка самих станочников. Точная измерительная линейка не руководит цехом; она даёт мастеру и руководителю цифры, с которыми решения принимаются быстрее и доказуемо. С распространением мониторинга роль опытного наладчика только растёт: кто-то должен превратить график потерь в изменённую наладку.
Частые вопросы
Нужно ли вообще проводить мониторинг станков — или это трата времени? На профильных форумах этот вопрос ставили на голосование: за «в этом есть смысл» проголосовало в шесть раз больше специалистов, чем за «это только трата времени». Мониторинг окупается там, где есть потери: пересменки, ожидания, скрытые остановы. Если цех на 3 станка и мастер видит каждый, автоматика даст меньше — начните с простого журнала.
Сколько стоит подключение одного станка? Цену определяют два фактора: способ сбора и объём работ по сети. Современная стойка с штатной сетевой опцией подключается программно — это дешевле; станок без сети требует модуля и датчиков тока — дороже по железу, но без вмешательства в стойку. На западном рынке в обсуждениях фигурируют порядка нескольких тысяч долларов за станок при самостоятельной сборке; в российских проектах цена вопроса на один станок при пилоте обычно сопоставима со стоимостью одного-двух часов его внепланового простоя.
Это слежка за людьми? Как реагирует персонал? Система видит станок, а не человека: статусы, программы, нагрузки. Личные показатели из этого не следуют напрямую — счёт деталей зависит от заготовок, инструмента и наладки не меньше, чем от оператора. Опыт показывает: когда цеху показывают найденные потери и убирают их, отношение меняется; когда система используется только для наказаний — конфликт почти гарантирован.
Что делать со старыми станками без сети и вообще без ЧПУ? Их подключают через дискретные и токовые датчики: датчик на силовом кабеле различает «работает/стоит» и считает энергию, свободный контакт реле отдаёт сигнал аварии. Так в общий отчёт встают и станки 1970-х годов выпуска. Данных меньше, чем с современной стойки, но факт загрузки и простоя — основа решений — будет.
Не повлияет ли мониторинг на гарантию станка? Корректное подключение использует штатные читающие интерфейсы стойки и не меняет параметры, программы и электрику — это операция из документации производителя. Датчики на узлах добавляются как опции и снимаются без следов. На станках на гарантии работы согласуются с сервисной организацией: влезать в стойку с самописным ПО ради мониторинга действительно не стоит.
Что такое OEE и нужен ли он небольшому цеху? OEE — общая эффективность оборудования: произведение доступности, производительности и качества, методика закреплена в ГОСТ Р ИСО 22400. Малому цеху сам термин не обязателен, а составляющие нужны: сколько часов станок был способен работать, сколько из них резал и сколько годных деталей дал. На 5–10 станках эти три цифры по каждому станку заменяют весь управленческий учёт.
Заключение: план на ближайший месяц
Мониторинг станков даёт руководителю три вещи: честные цифры загрузки и простоев по каждому станку, ТО и ЗИП по фактической наработке вместо календаря и основание для решений — от перестройки смен до отказа от покупки нового станка. Цифры эффектов (простои −30–40%, загрузка +15–25%, окупаемость 2–6 месяцев) — не гарантия, а ориентир: ваш собственный результат считает пилот.
Эта неделя: выпишите пять вопросов, на которые вам не хватает данных, и выберите 2–3 станка пилота по критериям из таблицы. Поставьте у станков простую таблицу и начните базовый замер «до».
В течение месяца: проведите пилот с еженедельными 30-минутными разборами, зафиксируйте найденные потери в часах, посчитайте их в деньгах через стоимость часа простоя и примите решение о масштабировании на основе своей цифры.
Если нужен внешний толчок: начните с технического аудита станочного парка — он покажет состояние, возраст и загрузку каждой единицы и станет готовой основой для выбора станков пилота. Подключение датчиков и систем мониторинга для станков выполняется без остановки производства — на работающем цехе. И помните главное: система не управляет цехом сама. Управляете вами — она лишь делает так, чтобы вы управляли фактами, а не мнениями.
Источники
- ГОСТ Р ИСО 22400-1-2016 «Системы промышленной автоматизации и интеграция. Ключевые технико-экономические показатели (KPIs) для управления производственными операциями. Часть 1. Общие положения, понятия и терминология»
- ГОСТ 27.002-2015 «Надежность в технике. Термины и определения»
- ГОСТ Р 71809-2024 «Цифровая промышленность. Унифицированная архитектура OPC» (стандарт на протокол обмена данными OPC UA)
- FANUC MT-LINK i — система мониторинга станков (CNC Machine Monitoring Software). FANUC America
- Manage MyMachines — мониторинг данных станков Siemens (Manage MyMachines — machine data monitoring). Siemens
- HEIDENHAIN StateMonitor — программное обеспечение мониторинга станков (StateMonitor: operational visibility for your machines). HEIDENHAIN
- MTConnect — открытый стандарт обмена данными с оборудованием (MTConnect Standard). MTConnect Institute
- umati — единый интерфейс станков на основе OPC UA (umati — universal machine technology interface). Инициатива VDW
- Чернобыль Г. «Ошибки и заблуждения заказчиков при подключении мониторинга станков». Портал isicad.ru, 22.12.2020
- «Информационно-измерительные системы мониторинга работы станочного парка предприятия». Научная статья, 2023 (DOI: 10.24412/2071-6168-2023-9-490-491)
- «Информационная система мониторинга станочного парка предприятия». Журнал «Информационно-измерительные и управляющие системы», №9, 2015
- «Мониторинг станков и предиктивный сервис — основа современного производства». Журнал «РИТМ машиностроения», №2, 2024